高斯分布(Gaussian Distribution)是一种连续概率分布,也称为正态分布(Normal Distribution)。高斯分布的概率密度函数(Probability Density Function, PDF)为:
f(x)=√2πσ1e−2σ2(x−μ)2
其中,μ 是均值(Mean),σ 是标准差(Standard Deviation)。
多元高斯分布的概率密度函数为:
f(x)=(2π)2d∣Σ∣211e−21(x−μ)TΣ−1(x−μ)
其中,μ 是 d 维均值向量,Σ 是 d×d 的协方差矩阵,d 是维度。
高斯分布的性质
- 高斯分布是一个钟形曲线,左右对称,中心点为均值 μ
- 标准差 σ 决定了曲线的宽窄,标准差越大,曲线越矮胖;标准差越小,曲线越瘦高
- 高斯分布的期望值为均值 μ,方差为 σ2
- 高斯分布的协方差矩阵 Σ 是对称正定矩阵
- 高斯分布的边缘分布是高斯分布(边缘分布是指将多元高斯分布中的某几个维度的变量积分掉后得到的分布)
- 高斯分布的条件分布是高斯分布(条件分布是指在已知某些变量的情况下,对另一些变量的分布)
- 高斯分布的线性变换仍然是高斯分布(线性变换是指 y=Ax+b,其中 A 是矩阵,b 是向量)
高斯分布会在不同的问题中产生,例如:
- 对于一个一元实值向量,使熵最大的分布是高斯分布
- 中心极限定理表明,独立同分布的随机变量和服从任意分布的随机变量的和,当样本量足够大时,其分布会趋近于高斯分布
高斯分布中的均值与方差的计算
首先,考虑高斯分布的二次型:
Δ2=(x−μ)TΣ−1(x−μ)
其中,Δ2 是一个标量,x 是一个列向量,μ 是一个列向量,Σ 是一个实对称正定矩阵
实对称正定矩阵的性质
对于一个实对称正定矩阵 Σ,存在一个正交矩阵 Q,使得 Σ=QΛQT,其中 Λ 是一个对角矩阵,对角线上的元素是 Σ 的特征值,那么按照特征值展开定理,有:
Σ−1=(QΛQT)−1=QΛ−1QT=i=1∑dλi1qiqiT
其中,qi 是 Q 的第 i 列(也就是第 i个特征向量),λi 是 Λ 的第 i 个对角元素
使用上面的公式代入二次型,有:
Δ2=(x−μ)TQΛ−1QT(x−μ)=(QT(x−μ))TΛ−1(QT(x−μ))
令 y=QT(x−μ),则有:
Δ2=yTΛ−1y=i=1∑dλiyi2
高斯分布的几何理解
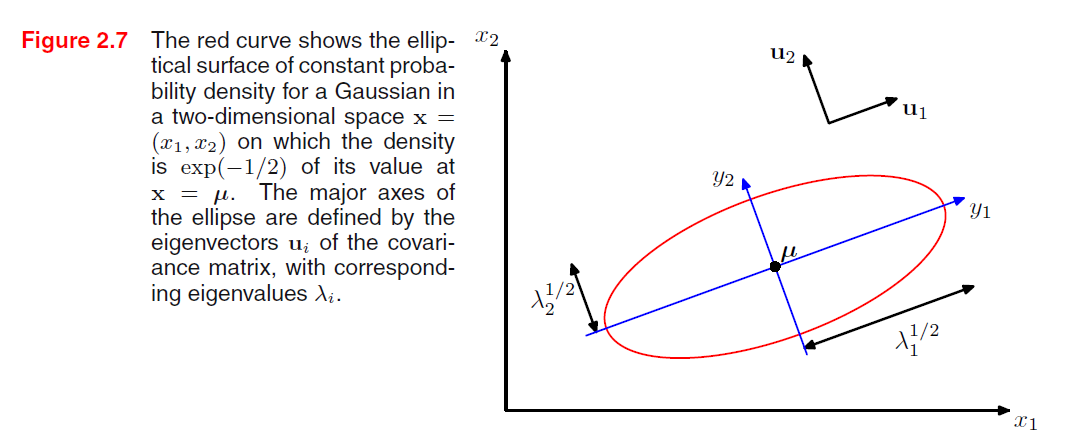
本质上,高斯分布的一般形式都可以看作是在标准形式 N(0,I) 上进行线性变换得到的. 对于一个二元高斯分布,其等高线是一个椭圆,椭圆的长轴和短轴方向分别是协方差矩阵的特征向量方向,长轴和短轴的长度分别是特征值的平方根. (我们讨论正定矩阵,也就是特征值全部大于零的情况,如果特征值大于等于零,那么我们会遇到一个退化的情况,也就是得到一个低纬度的椭圆,甚至是一个线段或者点)
这样,我们可以代入高斯分布的概率密度函数,得到:
p(y)=p(x)∣∣∣∣dydx∣∣∣∣=(2π)2d∣Σ∣211e−21yTΛ−1y=j=1∏d(2π)2d∣Σ∣211e−21λiyi2
这样,我们可以看出,高斯分布的每一个维度都是独立的,且服从标准正态分布 N(0,1),这样我们就可以得到高斯分布的均值和方差:
E[x]Var[x]=E[Qy+μ]=E[Qy]+μ=QE[y]+μ=μ=Var[Qy+μ]=Var[Qy]=QVar[y]QT=QΛQT=Σ
高斯分布的局限性
高斯分布的局限性主要体现在以下几个方面:
- 高斯分布参数量大,而且求逆计算的计算复杂度高,对于高维数据,计算量会很大
- 高斯分布本质是单峰,因此不能很好的近似多峰分布
解决这类的问题,我们可以通过引入潜在变量(隐藏变量、未观察变量)来解决,例如混合高斯分布